

Proxmox Restore-Test zum Festpreis - WZ-IT prüft primären und externen Backup-Weg, führt einen isolierten Restore durch und dokumentiert den erreichten Wiederherstellungspunkt sowie die gemessene Dauer. Restore-Test ansehen · PBS-Offsite-Architektur einrichten und betreiben lassen Termin vereinbaren · Mehr zu Proxmox Backup Server
Die PBS-Grundlagen erklären das Sicherungsmodell. Drei Kernfragen entscheiden, ob Ihre Backups eine Ransomware-Welle überstehen: Wer hat Zugriff auf was, wer initiiert die Datenbewegung, und wie lange leben Daten an welchem Ort? Bei Proxmox Backup Server (PBS) lassen sich diese Fragen architektonisch elegant beantworten - mit einer Pull-Architektur und asymmetrischer Retention zwischen primärem und Offsite-Standort.
Dieser Beitrag erklärt, warum die Sync-Richtung über die Sicherheit Ihrer Backups entscheidet, wie sich Retention sauber auf zwei Standorte verteilen lässt, was im NIS2-Kontext zu beachten ist und welche Hosting-Optionen für den externen PBS in der Praxis taugen.
Inhaltsverzeichnis
- Pull oder Push: Warum die Sync-Richtung entscheidet
- So funktioniert die Pull-Architektur
- Was zählt als Offsite-Backup?
- Deduplizierung: warum Offsite bezahlbar bleibt
- Asymmetrische Retention: lokal kurz, offsite lang
- PBS Sync-Job einrichten: Remote, Pull-Job, Flags und Verify
- Hosting-Optionen für den externen PBS
- 3-2-1-1-0 und der NIS2-Kontext
- Häufige Stolperfallen
- Unser Vorgehen bei WZ-IT
- Weiterführende Guides
Den Wiederanlauf über Standorte ordnet der Leitfaden DR-Muster und Runbook ein.
Pull oder Push: Warum die Sync-Richtung entscheidet
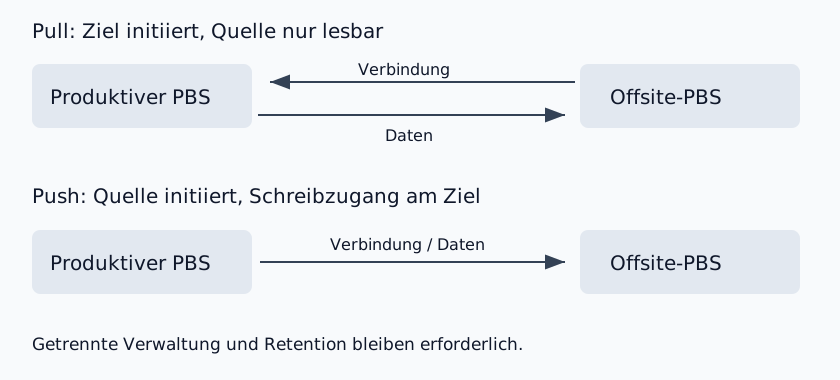
Proxmox Backup Server unterstützt zwei Modi für die Replikation zwischen zwei PBS-Instanzen: Pull (der Ziel-Server holt Daten aktiv vom Quell-Server) und Push (der Quell-Server schickt Daten an den Ziel-Server). Technisch erreichen beide das gleiche Ergebnis. Sicherheitstechnisch sind sie himmelweit verschieden.
Bei einem Push-Setup benötigt der produktive PBS Zugangsdaten mit Schreibrechten auf dem externen PBS. Bei kompromittierten Quellzugängen hängt der mögliche Schaden von den Zielrechten ab: Datastore.Backup erlaubt neue Snapshots, aber kein pauschales Überschreiben oder Löschen bestehender Backups. Zum Löschen benötigt der Zielbenutzer Datastore.Prune und die Eigentümerschaft der Backups. Weitergehende Verwaltungsrechte erweitern den möglichen Schaden. Siehe PBS-Berechtigungsmodell.
Bei einem Pull-Setup initiiert der Offsite-PBS die Verbindung und liest die Quelle. Die Quelle benötigt keine Zugangsdaten zum Ziel. Getrennte Administration, Firewall-Regeln und eigene Retention begrenzen Löschpfade; gegen kompromittierte Zielzugänge braucht es weitere Schutzmaßnahmen.
Pull begrenzt die Rechte auf der Quelle. Das ist eine Architekturentscheidung, keine pauschale Herstellerempfehlung. Für Push verlangt die PBS-Dokumentation eine eigene Remote-Konfiguration und einen begrenzten Remote-User je Sync-Job.
Der Offsite-PBS benötigt ausgehenden Zugriff auf die Quelle über TCP 8007, die Quell-Firewall erlaubt diesen eingehenden Zugriff gezielt. TLS und ein unabhängig geprüfter Zertifikats-Fingerprint sichern die Verbindung.
So funktioniert die Pull-Architektur
Eine produktionsreife PBS-Pull-Architektur besteht aus drei Komponenten:
Der lokale PBS sitzt im Produktiv-Netz, idealerweise in einem HA-Proxmox-Cluster integriert. PVE-Hosts schicken VM- und Container-Backups dorthin. Inkrementelle Übertragung mit Deduplizierung sorgt dafür, dass nach dem ersten Vollbackup nur noch Deltas über die Leitung gehen.
Der Offsite-PBS steht in einem geografisch und administrativ getrennten Rechenzentrum. Er holt sich neue Snapshots per Pull, dedupliziert sie noch einmal in seinen eigenen Datastore und wendet seine eigene Retention-Policy an. Die für den Pull benötigte Verbindung geht vom Offsite-PBS zur Quelle - keinerlei Verbindungen vom Internet zum Offsite-Server.
Der Sync-User ist ein dedizierter API-User auf dem lokalen PBS mit ausschließlich der Rolle DatastoreReader auf einem konkreten Datastore. Statt Passwort empfiehlt sich ein API-Token, das ohne Login-Eingriff rotiert werden kann. Schreibrechte hat dieser User nirgendwo - selbst wenn das Token kompromittiert würde, kann der Angreifer höchstens lesen, nicht zerstören.
Beim Pull lädt der Offsite-PBS für jeden zu syncenden Snapshot zuerst die Snapshot-Indizes vom Quell-PBS herunter. Existiert ein referenzierter Chunk bereits im Offsite-Datastore (etwa weil er durch einen vorherigen Sync vorhanden ist oder weil eine andere VM denselben Inhalt hat), wird er nicht erneut übertragen. Nur fehlende Chunks werden übertragen. Auch über die Leitung wirkt die Deduplizierung also voll.
Konfigurativ landen Sync-Jobs in /etc/proxmox-backup/sync.cfg, Remote-Definitionen in /etc/proxmox-backup/remote.cfg. Beide Dateien sind versionierbar und gehören in Ihre Provisioning-Pipeline.
Was zählt als Offsite-Backup?
"Offsite" wird in der Praxis oft mit "extern" oder "auf einem anderen Server" verwechselt. Das ist gefährlich. Ein PBS im selben Rack wie der PVE ist off-host, ein PBS im selben Standort, aber außerhalb des PVE-Clusters ist off-cluster - beides hilft gegen Hardware-Ausfälle eines einzelnen Servers, aber nicht gegen Brand, Wassereinbruch, RZ-Stromausfall, Diebstahl oder einen Hoster, der den Account sperrt.
Echtes Offsite verlangt drei Trennungen:
Geografisch. Als Planungsregel bewerten wir gemeinsame Risiken durch Stromversorgung, Hochwasser, Brand und Netzstörungen. Eine pauschale Kilometerzahl ersetzt die Standortprüfung nicht.
Administrativ. Idealerweise nicht beim selben Hoster wie das Primärsystem. Wer auf Hetzner produktiv läuft, sollte den Offsite-Standort woanders haben - nicht weil die Hetzner-Standorte unsicher wären, sondern weil eine Account-Sperrung (verspätete Zahlung, kompromittierte Hoster-Credentials) sonst beide Standorte gleichzeitig abschalten kann.
Rechtlich. Bei Insolvenz oder einem Konflikt mit dem Primärprovider sollten die Offsite-Daten weiter erreichbar sein. Provider-Diversität ist auch ein juristisches Argument.
Standorte und Verwaltungsdomänen getrennt wählen; Datenschutzanforderungen anhand von Verträgen, Datenwegen und Betriebsmodell prüfen.
Deduplizierung: warum Offsite bezahlbar bleibt
Offsite-Storage scheint zunächst teuer - bis man versteht, wie aggressiv PBS dedupliziert. Die Mechanik:
VM-Backups werden in Fixed-Size-Chunks von 4 MiB zerlegt. Jeder Chunk bekommt einen SHA-256-Hash. Identische Chunks (etwa in mehreren Snapshots derselben VM oder in mehreren VMs mit gleichem Basis-Image) landen nur einmal physisch im Datastore - nachfolgende Snapshots referenzieren dieselbe Datei.
Container- und Host-Backups werden in dynamische Chunks zerlegt, deren Grenzen ein Buzhash-Rolling-Hash über pxar-Archive bestimmt. Der Vorteil: Bei einer kleinen Änderung in der Mitte einer großen Datei verschiebt sich nicht die ganze Chunk-Aufteilung - nur der betroffene Chunk wird neu.
Inkrementell mit Bitmap. Bei laufenden VMs trackt QEMU geänderte Blöcke per Dirty Bitmap. PBS liest dann nur diese Blöcke und überträgt nur die unbekannten Chunks. Wichtig zu wissen: Die Bitmap lebt im RAM. Nach VM-Stop, Restart oder Migration ist sie weg, und das nächste Backup muss wieder die ganze Disk lesen - überträgt aber trotzdem nur unbekannte Chunks. Längere Laufzeit, kein Mehrverbrauch an Speicher.
Cross-VM-Dedup. Fünf VMs mit Debian-12-Base teilen die Systemdateien. Drei Wochen tägliche Snapshots derselben VM teilen alles, was sich nicht geändert hat. PBS rechnet das automatisch raus.
Als Beispiel nennt ein Anbieterblog einen Nutzer, dessen NFS-Backups mit PBS von 7 TB auf knapp über 1 TB schrumpften. Wie stark die Deduplizierung greift, hängt von den Daten ab; der konkrete Faktor lässt sich pro Datastore in der WebUI einsehen, aktualisiert sich allerdings erst nach einem Garbage-Collection-Lauf.
Einige Grenzen sind zu beachten. Bei stark fragmentierten Datenbanken kann ein Byte-Update einen ganzen 4-MiB-Chunk neu schreiben. Wer auf Block-Ebene fein-granulare Deduplizierung braucht, muss zusätzlich auf Storage-Ebene mit ZFS-Dedup oder ähnlichem arbeiten. PBS ist als Backup-Layer ausgelegt, nicht als Storage-Engine.
Asymmetrische Retention: lokal kurz, offsite lang
Hier kommt eine Eigenart von PBS, die viele beim ersten Setup übersehen: Sync-Jobs sind unabhängig von Prune-Einstellungen. Stand Oktober 2026 überspringt der reguläre Pull pro Backup-Gruppe Snapshots, die älter als der neueste erfolgreiche Snapshot im Offsite-Datastore sind. Ist dort kein erfolgreicher Snapshot mehr vorhanden, können weiterhin verfügbare Quell-Snapshots erneut übertragen werden.
Daraus folgt die Regel: Retention muss in eine Richtung geplant werden - lokal kürzer als offsite, niemals umgekehrt. Wenn auf dem lokalen PBS nach 14 Tagen geprunt wird, bevor der nächste Sync läuft, geht der Snapshot offsite verloren.
Eine sinnvolle Aufteilung in der Praxis:
Lokaler PBS (kurz, schnell, operativ): keep-last 3 plus keep-daily 7. Schnelle Restores für die häufigen Fälle (versehentlich gelöschte VM, beschädigtes Update).
Offsite-PBS (lang, compliance): Die offizielle PBS-Doku zeigt eine 10-Jahres-Strategie: keep-last 3, keep-daily 13, keep-weekly 8, keep-monthly 11, keep-yearly 9. Damit haben Sie aktuell tagesgenaue Backups, gehen rückwirkend auf Wochen-, dann auf Monats-, dann auf Jahres-Granularität - bei minimalem Speicheraufwand dank Dedup.
Wichtig: Die keep-*-Optionen werden in Reihenfolge abgearbeitet (last → hourly → daily → weekly → monthly → yearly). Jede Option markiert nur Snapshots im eigenen Zeitfenster, die noch nicht von einer früheren Option markiert wurden. Wer das Zusammenspiel verstehen will, sollte den offiziellen Prune-Simulator nutzen - dort lassen sich Policies gegen Beispiel-Daten durchspielen.
Drei Stellen, an denen Retention konfiguriert werden kann - und das ist der häufigste Fehler:
- PBS Datastore (Prune & Garbage Collection-Tab)
- PVE-Storage-Konfiguration (PBS als Storage in PVE)
- PVE-Backup-Job
Wenn Retention an mehreren Stellen gesetzt ist, wirken alle parallel - und die aggressivste gewinnt. Die saubere Lösung: Retention ausschließlich am PBS-Datastore (oder Namespace) setzen, in der PVE-Storage-Konfiguration "Keep all backups" aktivieren. Zusätzlich sollte der PBS-User, mit dem PVE die Backups schreibt, kein Prune- oder Destroy-Recht haben - sonst kann ein kompromittierter PVE die eigenen Backups löschen.
Pruning entfernt übrigens nur die Snapshot-Referenz, nicht die zugrunde liegenden Chunks. Erst die Garbage Collection (typischerweise ein Wochenende-Job) löscht unreferenzierte Chunks nach einer Grace-Period von 24h plus 5 Minuten. Speicher wird also erst nach dem nächsten GC-Lauf wirklich frei.
PBS Sync-Job einrichten: Remote, Pull-Job, Flags und Verify
Ein paar Flags entscheiden zwischen "läuft sauber" und "produziert Datenverlust":
--remove-vanished false (empfohlen für asymmetrische Retention). Wenn auf der Quelle ein Snapshot gepruned wird, soll er auf dem Offsite nicht mit verschwinden. Auf true gesetzt würde der Pull-Job den Offsite zum reinen 1:1-Mirror machen - was die ganze Retention-Asymmetrie zerstört.
--verified-only true synchronisiert nur Snapshots, die auf der Quelle erfolgreich verifiziert wurden; mit encrypted-only lässt sich die Auswahl zusätzlich auf verschlüsselte Snapshots beschränken. Beides ist besonders relevant, wenn der Offsite-PBS in einer weniger vertrauenswürdigen Umgebung läuft (Dokumentation).
--encrypted-only true zieht nur clientseitig verschlüsselte Snapshots offsite. Wenn Sie clientseitige Verschlüsselung mit AES-256-GCM einsetzen - was bei Offsite-Storage Pflicht sein sollte - verhindert dieses Flag, dass versehentlich unverschlüsselte Backups das Haus verlassen.
--rate-in <Bandbreite> begrenzt die Sync-Geschwindigkeit. Bei knappem Uplink (etwa 50 Mbit/s in einem KMU-Anschluss) macht es Sinn, den Sync unterhalb der Leitungskapazität zu deckeln, damit das Tagesgeschäft nicht ausgebremst wird. Die Einheit ist Bytes pro Sekunde: 50 Mbit/s entsprechen rund 6 MiB/s, ein Limit von 4 MiB/s (rund 34 Mbit/s) lässt Reserve für den übrigen Verkehr. Das Beispiel 20MiB in der Proxmox-Dokumentation ist ein Syntaxbeispiel, kein Richtwert für schmale Uplinks. Tipp: Sync-Jobs in die Nachtstunden legen.
--ns und --remote-ns mappen Namespaces. Pro Mandant einen Namespace im selben Datastore: getrennte ACLs, getrennte Prune-Policies, aber gemeinsame Deduplizierung. Bei mandantenfähigen Setups oder Hosting-Szenarien ist das oft die richtige Antwort.
--schedule akzeptiert die Calendar-Event-Syntax von systemd: daily 03:30, *-*-* 02:00, Wed 02:30. Sync-Jobs sollten nach den Backup-Jobs laufen, aber vor den Prune-Jobs.
Die Einrichtung verteilt sich auf Quell- und Offsite-PBS (PBS-Doku).
Auf dem Quell-PBS ausführen: Benutzer und Token anlegen, Leserechte vergeben und den Fingerprint der Quelle auslesen.
proxmox-backup-manager user create sync@pbs
proxmox-backup-manager acl update /datastore/datastore1 DatastoreReader --auth-id sync@pbs
proxmox-backup-manager user generate-token sync@pbs offsite
proxmox-backup-manager acl update /datastore/datastore1 DatastoreReader --auth-id 'sync@pbs!offsite'
proxmox-backup-manager cert info
Auf dem Offsite-PBS ausführen: Das Token-Secret der Quelle und deren unabhängig geprüften Fingerprint einsetzen; Platzhalter vor Ausführung ersetzen. Secrets nicht in gemeinsam genutzten Shell-Verläufen speichern.
proxmox-backup-manager remote create source-pbs \
  --host source-pbs.example \
  --userid 'sync@pbs!offsite' \
  --password '<TOKEN-SECRET>' \
  --fingerprint '<SHA256-FINGERPRINT>'
Den folgenden Pull-Sync-Job ebenfalls auf dem Offsite-PBS anlegen. Die gezeigten Befehle folgen der Dokumentation für PBS 4.2. Datastores müssen bereits existieren. Auf der Quelle haben User und Token nur DatastoreReader. Für die Job-Konfiguration am Ziel gelten Remote.Read auf /remote/source-pbs/datastore1 und mindestens Datastore.Backup auf /datastore/offsite; bei abweichendem Owner zusätzlich Datastore.Modify. Siehe Rechte und Sync und Token-Verwaltung.
proxmox-backup-manager sync-job create offsite-pull \
  --remote source-pbs \
  --remote-store datastore1 \
  --store offsite \
  --remove-vanished false \
  --verified-only true \
  --encrypted-only true \
  --rate-in 4MiB \
  --schedule '02:30'
Die PBS-4.2-Dokumentation beschreibt auch serverseitige Verschlüsselung beim Sync: Push kann bisher unverschlüsselte Snapshots vor der Übertragung verschlüsseln; bereits verschlüsselte Inhalte bleiben unverändert. Pull kann mit zugeordneten Schlüsseln entschlüsseln. Das verändert die Schlüssel- und Vertrauensgrenze und wird getrennt vom gezeigten encrypted-only-Pull geplant.
Für den ersten Server: PBS einrichten und anbinden. Für ein S3-Ziel: PBS mit Hetzner Object Storage einrichten und prüfen, einschließlich Grenzen und Wiederanlauf.
Hosting-Optionen für den externen PBS
Fünf Architektur-Varianten, abhängig von Volumen, Compliance-Anforderung und Budget:
netcup Root Server mit Local Block Storage. Aktuelle Generation G12.5 mit AMD EPYC 9645 und DDR5-ECC-RAM. Local Block Storage bis 8 TB pro Server, ohne Mindestlaufzeit erweiterbar. Standorte Nürnberg oder Wien. PBS profitiert spürbar von lokalem Block-Storage statt Network-Filesystemen - Garbage Collection und Verify werden deutlich schneller. Standort in der EU.
Hetzner Storage Box als CIFS-Mount. Preislich attraktiv. Bei einem CIFS-Mount sind Dateisystemkompatibilität und Laufzeiten für Backup, Verify, Garbage Collection und Restore im konkreten Setup zu prüfen. Eine mögliche Ergänzung ist der Einsatz als zusätzliche Cold-Layer neben einem Offsite-Ziel mit lokalem Block-Storage.
Managed-PBS-Anbieter. Spezialisierte Anbieter übernehmen PBS-Betrieb im jeweiligen Tarif. Speicher, Retention, Zugriffsrechte, Schlüsselverwaltung und Exportmöglichkeiten vor Beauftragung prüfen; eine pauschale Preisspanne ist nicht belastbar.
Eigene Hardware in einem zweiten Rechenzentrum. Volle Kontrolle über Hardware und Anbindung. Ob das wirtschaftlich ist, hängt von Kapazität, Hardware-, Standort-, Anbindungs- und Betriebskosten ab.
S3-Datastore seit PBS 4.2 stabil. PBS kann S3-kompatiblen Object Storage als Datastore verwenden. Stand Oktober 2026 unterstützt PBS 4.2 Object Lock und Bucket-Versionierung nicht (Proxmox-Mitarbeiter im Forum). Eine unveränderliche oder offline gespeicherte Kopie wird deshalb über einen getrennten Speicher- oder Exportweg geplant und nicht durch WORM-Regeln auf dem laufenden PBS-Datastore erzwungen.
Eine Offsite-PBS-Instanz kann WZ-IT im Rahmen von Aufbau und Betrieb umsetzen. Für Serverressourcen siehe Proxmox Hosting.
3-2-1-1-0 und der NIS2-Kontext
Die klassische Backup-Regel "3-2-1" - drei Kopien, zwei Medien, eine offsite - wird im Ransomware-Zeitalter um zwei Stellen erweitert: 3-2-1-1-0. Eine zusätzliche Kopie soll immutable oder offline sein (gegen Ransomware), und 0 Fehler sollen Verify-Jobs zeigen.
Eine Pull-PBS-Architektur deckt 3-2-1 elegant ab:
- 3 Kopien: Original auf PVE-Storage, Backup auf lokalem PBS, Sync auf externen PBS
- 2 Medien: PVE-Storage und PBS-Datastore (oder zwei PBS-Datastores auf unterschiedlichem Storage)
- 1 offsite: der externe PBS
Die zusätzliche unveränderliche oder offline gespeicherte Kopie verlangt einen getrennten Weg, etwa Tape oder ein rotierendes Medium, das nur für den vereinbarten Sicherungsprozess verbunden wird. Die konkrete Methode muss zu Löschfristen, Datenmenge und Wiederanlaufziel passen.
Verify-Jobs auf 0 Fehler sind kein Nice-to-have. Ein Backup, das nie restored oder verifiziert wurde, ist Hoffnung - kein Backup. Quartalsweise Restore-Tests einer Test-VM aus dem Offsite-Datastore gehören in den Operations-Kalender.
Im NIS2-Kontext können Backup, Wiederherstellung, Lieferkette und dokumentiertes Risikomanagement relevant sein. Die konkrete Anwendbarkeit und rechtliche Bewertung ist organisationsabhängig. Technisch kann eine PBS-Pull-Architektur nachvollziehbare Datenwege, Retention, Verify-Ergebnisse sowie definierte RTO/RPO und ausdrücklich vereinbarte Restore-Tests unterstützen.
Wer tiefer in das Thema einsteigen will: Wir haben dazu einen ausführlichen Beitrag geschrieben - "Linux-Kernel-Schwachstellen 2026: Warum Patch-Management jetzt Chefsache ist" ordnet den NIS2-Kontext im Detail ein.
Häufige Stolperfallen
Typische Stolperfallen:
Latenz frisst Bandbreite. Sync-Geschwindigkeit hängt nicht nur vom Uplink ab, sondern auch von der Round-Trip-Time zwischen Source und Destination. Bei hoher Latenz oder Packet-Loss bremst die TCP-Congestion-Control aggressiv ein. Workaround: WireGuard-Tunnel mit BBR-Congestion-Control. Der Bug-Tracker-Eintrag 4182 dokumentiert das Problem im Detail.
Initial-Sync lokal machen. Der erste Sync kann bei mehreren Terabyte über einen 50-Mbit/s-Uplink Tage dauern. Eine Möglichkeit ist, den Offsite-PBS lokal aufzubauen, den ersten Sync im lokalen Netz laufen zu lassen und die Maschine anschließend an den Zielstandort zu bringen. Configs werden danach auf die neue IP angepasst, der Datastore ist bereits gefüllt. Alternativ: Removable Datastores für den Initial-Sync per externer Platte.
Verify-Jobs einrichten - auf beiden Seiten. Auf der Quelle, um Bit-Rot frühzeitig zu erkennen. Auf dem Offsite, um zu wissen, dass der Sync nicht stillschweigend kaputte Chunks übertragen hat. Verify ist IO- und CPU-intensiv; das Schedule sollte zwischen GC und Sync liegen.
Encryption-Keys offsite hinterlegen. Wenn Backups clientseitig verschlüsselt sind und der Schlüssel nur auf dem zerstörten PVE liegt, sind die Backups unbrauchbar. Schlüssel gehört in einen Cloud-Passwort-Manager (Bitwarden, 1Password) plus eine Offline-Kopie an einem zweiten Standort - im Notfall ein gedruckter QR-Code im Bankschließfach. Ja, wirklich.
DNS-Failover für Restore vorbereiten. Im Disaster-Recovery-Fall ist der lokale PBS oft auch weg. Restore muss direkt vom externen PBS auf einen frisch installierten PVE funktionieren. Heißt: externer PBS muss erreichbar sein, Credentials müssen verfügbar sein (Passwort-Manager mit Offline-Backup), Encryption-Keys müssen sicher hinterlegt sein, Restore-Walkthrough muss dokumentiert sein. Restore-Test ist Pflicht, nicht Kür.
Namespaces für Mandantenfähigkeit nutzen. Pro Kunde oder pro Workload-Klasse einen Namespace im selben Datastore: getrennte ACLs, getrennte Prune-Policies, getrennte Sync-Filter. Aber: Wenn dieselbe VM in zwei Namespaces gesichert wird, geht die Dirty Bitmap verloren - komplette Disk muss bei jedem Backup neu gehasht werden. Praktisch heißt das: Eine VM lebt in genau einem Namespace.
Drei Retention-Stellen - eine Quelle der Wahrheit. Wir haben es oben erwähnt, es ist aber so wichtig, dass es zweimal gehört: Retention nur am PBS-Datastore. PVE-Job auf "Keep all backups". Sonst marken Sie sich Snapshots weg, von denen Sie hofften, sie offsite zu haben.
Bandbreiten-Asymmetrie beachten. Privatanschlüsse haben oft 1 Gbit/s Down, 50 Mbit/s Up. Initial-Sync vom Offsite zurück (im DR-Fall) ist schnell - Sync ins Offsite ist langsam. Bei Business-Anschlüssen meist symmetrisch, aber lohnt sich zu prüfen.
Unser Vorgehen bei WZ-IT
Bei WZ-IT bauen und betreiben wir PBS-Pull-Architekturen als integralen Teil unserer Proxmox & Private Cloud-Services. Drei Stationen:
Architektur-Workshop (Proxmox Beratung). Gemeinsam mit Ihnen klären wir Datenmenge, RTO/RPO-Anforderungen, Compliance-Pflichten (NIS2, ISO 27001, BSI C5) und Bandbreiten-Realitäten. Output: ein Architektur-Dokument mit Hosting-Empfehlung, Retention-Policy, Verschlüsselungs-Strategie und Restore-Runbook.
Aufbau der Pull-Architektur (PBS einrichten und betreiben). Lokaler und externer PBS passend zu den Wiederherstellungszielen, dedizierter Sync-User mit DatastoreReader-Rolle, getrennte Schlüsselablage sowie definierte Verify-Jobs. Restore-Tests und Infrastructure as Code werden bei Bedarf ausdrücklich vereinbart.
Betrieb mit definierten Service Levels (Proxmox-Wartung). Wir überwachen vereinbarte Sync-, Garbage-Collection- und Verify-Jobs und bewerten Security Advisories für PBS, Host-System und Kernel. Restore-Tests, Reports und weitergehende Recovery-Leistungen werden nach Bedarf als eigener Umfang bestätigt.
Für nachweispflichtige Umgebungen können Datenwege, Retention, Verschlüsselung, Verify-Ergebnisse und durchgeführte Restore-Tests im vereinbarten Umfang dokumentiert werden. Ob diese Unterlagen einen konkreten regulatorischen Nachweis erfüllen, wird separat bewertet.
Prüfen Sie die Offsite-Kopie mit einem isolierten PBS-Restore-Test. Dabei muss auch der unabhängig verwahrte Verschlüsselungsschlüssel verfügbar sein.
Weiterführende Guides
- PBS-Grundlagen
- PBS-Restore-Test: Anleitung
- Proxmox Backup Server vs. Veeam - welche Backup-Lösung für Proxmox VE, mit Kostenbeispiel
- Proxmox Backup Server (Hub) - Übersicht zu PBS, S3-Backend und Managed-Service-Optionen
- Proxmox Disaster Recovery - RTO/RPO, Failover-Runbooks und DR-Drills für den ganzen Cluster
- Proxmox Security Hardening - Managementzugänge, Rollen, Netzwerk, Logging und Updateweg prüfen
- Linux-Kernel-Schwachstellen 2026: Patch-Management Chefsache - der NIS2-Kontext im Detail
- CVE-Monitoring für Self-Hosted Software - wie man strukturell auf CVE-Veröffentlichungen reagiert
- PBS 4.2 S3 Storage Stable - S3-Datastores und ihre Betriebsgrenzen
Sie planen ein PBS-Offsite-Setup oder möchten Ihre aktuelle Backup-Architektur einordnen lassen? Wir klären Pull oder Push, lokalen oder externen PBS, S3 oder getrennte Offline-Kopie und grenzen den benötigten Prüf- und Betriebsumfang ab.
Kostenloses Backup-Architektur-Review buchen · Mehr zu PBS · Proxmox-Hub
Für ein externes Backup-Ziel beschreibt PBS-Hosting die individuell vereinbarte Offsite-Option.
























