
Architektur und Migration
Sizing, Zielumgebung, Datenübernahme, Cutover und Wiederanlauf werden vor dem produktiven Betrieb geklärt.


WZ-IT plant, installiert und betreibt PrivateGPT als Managed Hosting, in Ihrer Cloud oder on-premises. Je nach Zielbild übernehmen wir Migration, sichere Netzwerk- und Identity-Anbindung, Monitoring, Backups, Updates sowie Integrationen und Weiterentwicklung.
Unternehmen weltweit vertrauen WZ-IT
Die genannten Namen sind Marken ihrer jeweiligen Inhaber: PrivateGPT (Zylon by PrivateGPT). WZ-IT ist ein unabhängiger Dienstleister und steht in keiner geschäftlichen, partnerschaftlichen oder vertraglichen Beziehung zu diesen Unternehmen. Wir bieten unabhängige Migrations-, Installations-, Hosting- und Betriebsdienstleistungen an.
PrivateGPT stellt Bausteine für dokumentenbasierte RAG-Anwendungen mit Large Language Models bereit. Dokumentenverarbeitung, Retrieval und Modellzugriff können lokal betrieben werden; bei Remote-LLM- oder Embedding-Anbietern werden die jeweils übermittelten Inhalte extern verarbeitet.
Die Plattform unterstützt lokale und entfernte Modellanbieter. Wir legen Datenflüsse, Modellzugriffe, Vektorspeicher und Berechtigungen deshalb passend zum Schutzbedarf aus, statt aus Self-Hosting pauschal Datenschutzkonformität abzuleiten.
Wir installieren, hosten und betreiben PrivateGPT wahlweise On-Premise oder auf abgestimmter Infrastruktur in Deutschland. Lokale und externe Modell- sowie Embedding-Dienste werden als nachvollziehbare Datenflüsse geplant.
Wir bieten 24/7-Monitoring, Backups und Wartung für Ihre PrivateGPT-Instanz. Menschliche Reaktionszeiten und Supportzeiten richten sich nach dem gewählten Service Level. Inklusive Unterstützung bei der Integration Ihrer bevorzugten LLM-Provider, der Dokumenten-Ingestion und RAG-Optimierung.
Dokumente, Embeddings und Modellanfragen können bei vollständig lokaler Konfiguration in der eigenen Umgebung bleiben. Externe Provider werden als eigene Datenflüsse bewertet und freigegeben.
RAG-Pipeline mit Dokumenten-Parsing, Splitting, Metadaten, Embeddings und Chunk-Retrieval. Ergebnisqualität und Quellenbezug werden anhand des konkreten Bestands getestet.
FastAPI-basierte Architektur mit OpenAI-kompatiblen Endpunkten. Benötigte Parameter, Streaming-, Tool- und Client-Funktionen werden versionsbezogen getestet und bei Bedarf angepasst.
Kann komplett offline und lokal betrieben werden - on-premise, in Ihrer Private Cloud oder Air-Gapped-Umgebung. Keine Abhängigkeit von externen Cloud-Diensten.
Unterstützt lokale Provider (Ollama, LlamaCPP) und Remote-Provider (OpenAI, Azure OpenAI, Sagemaker, etc.). Wechseln Sie flexibel zwischen verschiedenen Modellen.
Dokumentenverarbeitung mit Parsing, Chunking, Metadaten und Embeddings. Ergebnisqualität und unterstützte Formate hängen von Version, Parsern und Konfiguration ab.
Bei lokaler Auslegung lassen sich Speicherorte, Identitäten und Netzwerkpfade kontrollieren. Die rechtliche Zulässigkeit hängt zusätzlich vom konkreten Einsatzzweck und den angebundenen Diensten ab.
Der öffentlich einsehbare Quellcode steht unter Apache-2.0-Lizenz und kann technisch geprüft und angepasst werden. Modelle und weitere Abhängigkeiten werden separat bewertet.
Basiert auf LlamaIndex Framework. Freie Wahl zwischen verschiedenen LLM-Providern, Vektordatenbanken und Deployment-Modellen ohne Abhängigkeit von einzelnen Anbietern.
Professionelle Installation auf Ihrer Infrastruktur - On-Premise, Cloud oder Hybrid
In Ihrem Rechenzentrum
AWS, Azure, Hetzner & Co.
Erweiterte Architektur nach technischer und lizenzrechtlicher Prüfung
Vertrauliche Dokumente in einer kontrollierten Umgebung durchsuchen; Datenflüsse, Modellzugriffe und Telemetrie werden entsprechend Ihrer Architektur konfiguriert
Kontrollierbare Datenflüsse für Organisationen mit erhöhtem Schutzbedarf; rechtliche und fachliche Anforderungen werden projektbezogen geprüft
Production-ready RAG mit intelligentem Dokumenten-Parsing, Embeddings-Generierung und kontextbasierter Chunk-Retrieval für präzise Antworten
Flexible Nutzung von lokalen LLMs (Ollama, LlamaCPP) oder Remote-Providern (OpenAI, Azure OpenAI, Gemini) je nach Anforderung
Komplett offline betreibbar für mehrschichtige Sicherheitsmaßnahmensanforderungen, isolierte Netzwerke und Air-Gapped-Umgebungen ohne externe Abhängigkeiten
FastAPI-basierte Architektur mit OpenAI-kompatibler API für nahtlose Integration in bestehende Tools und Workflows ohne Code-Änderungen
Sichere Einwahl und Zugriffskontrolle für Ihre Installation
WireGuard, NetBird oder Tailscale
Direkt oder über vorgeschalteten Identity-Layer
Abhängig von Anwendung, Edition und Identity Provider
Fail2Ban, Rate Limiting, IP Whitelisting
Wir richten für Sie einen sicheren VPN-Zugang zu Ihrer Installation ein - ideal für Remote-Work und externe Mitarbeiter.
Full-Service Installation ohne versteckte Kosten
PrivateGPT ermöglicht lokale LLM-Nutzung mit eigenen Dokumenten. Wir integrieren es in Ihre bestehende Infrastruktur und erweitern die Fähigkeiten.
Über die API binden wir PrivateGPT an Ihre Systeme an: Chat-Completion, Document Ingest, und Context-Retrieval lassen sich programmatisch steuern.
Wir entwickeln Custom Ingestion Pipelines: Spezielle Dokumenttypen (CAD, Verträge, Code) werden mit optimierten Chunking-Strategien verarbeitet.
Das LlamaIndex-Backend erlaubt tiefe Anpassungen: Custom Retrievers, Reranker, und Embedding-Modelle für domänenspezifische Suche.
So setzen wir PrivateGPT-Entwicklung in der Praxis um.
Hochsensible Umgebungen (Behörden, Verteidigung) dürfen keine Cloud-Verbindung haben, brauchen aber LLM-Fähigkeiten.
Vollständig offline-fähiges Setup mit lokalen Modellen, eigenen Embeddings, und airgapped Update-Mechanismen.
Anwälte müssen tausende Dokumente nach relevanten Passagen durchsuchen. Manuelle Sichtung dauert Wochen.
PrivateGPT mit juristisch optimiertem Chunking und Retrieval. Fragen in natürlicher Sprache, Antworten mit Quellennachweis.
Führungskräfte bekommen hunderte E-Mails täglich. Zusammenfassungen und Priorisierung werden benötigt.
PrivateGPT-Integration, die E-Mails analysiert, zusammenfasst, und nach Dringlichkeit kategorisiert - vollständig on-premise.
Wir stellen nicht nur eine Anwendung bereit. WZ-IT plant die technische Architektur, bindet Netzwerk und Identitäten an, übernimmt den vereinbarten Betrieb und entwickelt Integrationen weiter, wenn der Standard nicht ausreicht.
Sizing, Zielumgebung, Datenübernahme, Cutover und Wiederanlauf werden vor dem produktiven Betrieb geklärt.
SSO, sichere Zugänge, interne Systeme und vorhandene Security-Komponenten werden passend eingebunden.
Updates, Backups, technische Überwachung und Reaktionswege folgen einem transparenten Betriebsumfang.
APIs, Automatisierungen und individuelle Erweiterungen können über die reine Bereitstellung hinaus umgesetzt werden.
Der konkrete Umfang hängt von Anwendung, Edition, Infrastruktur und Kritikalität ab. Herstellerlizenzen und Sonderkomponenten werden separat ausgewiesen.
KI-Anwendungen benötigen neben der Oberfläche kontrollierte Modellzugänge, Wissensquellen, Berechtigungen und Beobachtbarkeit. Wir planen diese Datenflüsse als zusammenhängenden Stack.
Teams, Fachanwendungen und API-Clients greifen über definierte Oberflächen und Schnittstellen zu.
TLS, Firewall-Regeln, Reverse Proxy oder private Netzwerkpfade werden passend zur Exposition der Plattform geplant.
Lokale Konten, SSO, Verzeichnisdienste, Service Accounts und Notfallzugänge werden mit klaren Rollen verbunden.
Anwendungslogik, Modellzugriffe, Rollen und freigegebene Funktionen laufen in einer kontrollierten Umgebung.
Lokale oder externe Modelle, GPU-/CPU-Ressourcen, Routing, Limits und Kostenkontrolle.
Dokumente, Datenbanken, Vektorsuche und nachvollziehbare Datenpfade für RAG und Suche.
Geprüfte Tools, APIs, Protokollierung, Metriken und technische Qualitätskontrollen.
Modelle, Erweiterungen und Datenquellen werden nicht pauschal freigeschaltet. Berechtigungen, Datenabfluss, Kosten und fachliche Kontrolle werden je Anwendungsfall bewertet.
Ein klarer Betriebsumfang statt einer unübersichtlichen Hosting-Pauschale.
Wir richten eine Testinstanz für Sie ein, in der Regel am nächsten Werktag. Ohne Zahlungsdaten. Nach sieben Tagen wird sie gelöscht, sofern Sie nicht übernehmen.
Compute, Anwendungen, Speicher und Reaktionszeit werden getrennt ausgewiesen. So sehen Sie, was im laufenden Betrieb enthalten ist und welche Anforderungen erst nach einem technischen Assessment angeboten werden.
Wir planen auch individuelle PrivateGPT-Architekturen, Integrationen und Migrationsprojekte. Kontaktieren Sie uns für ein technisches Assessment.
Eine verwaltete PrivateGPT-Standardanwendung ist im Starter-Workload enthalten. Ab Business kommt ein flexibel nutzbares Betriebsbudget für planbare Leistungen innerhalb der regulären Servicezeit hinzu. Wählen Sie Compute, weitere Anwendungen, Speicher und das passende Service Level.
Ein Workload ist eine Compute-Instanz mit den darauf vereinbarten Anwendungen.
Ein Standard-App je Workload ist bereits enthalten. Zusätzliche dedizierte Server zählen als weitere Workloads.
7,99 € netto je zusätzliche 100 GB und Monat, inklusive täglichem verschlüsseltem Offsite-Backup mit 7 Tagen Aufbewahrung. Abgerechnet wird die bereitgestellte Kapazität, nicht die tatsächliche Belegung.
Wir setzen auch individuelle Sicherungsintervalle und Aufbewahrungsfristen um. Zum Beispiel: tägliche Sicherungen für 30 Tage und eine monatliche Sicherung für 12 Monate. Umfang, Speicherbedarf und Zusatzkosten werden separat vereinbart.
+299 € netto je Workload und Monat
Das Standard-Hosting läuft auf einer einzelnen Instanz ohne Hochverfügbarkeit. Für individuelle Architekturen wird die Ausfallsicherheit separat vereinbart.
Zero Downtime auf Anfrage
Verteilter Betrieb mit mehreren Instanzen, Datenbank-Cluster und rollierenden Updates, sodass ein Node-Ausfall keine Unterbrechung verursacht. Nur für dafür geeignete Anwendungen; Auslegung und Preis nach technischer Prüfung.
Diese Seite deckt Installation und vereinbarten Plattformbetrieb für PrivateGPT ab. Eigener Code, die Zugriffsschicht und besondere Vertraulichkeitsanforderungen bleiben klar getrennte, bei Bedarf ergänzbare Verantwortungsbereiche.
Anwendung pflegen
Individuelle Erweiterungen, Schnittstellen und Dependencies kontrolliert aktualisieren und weiterbetreiben.
ab 699,90 € netto / Monat
Leistung ansehenZugriff absichern
Identitätsbasierte Zugänge und private Netzwerkpfade als eigene Betriebsschicht ergänzen.
ab 349,90 € netto / Monat
Leistung ansehenVertraulich betreiben
Für Berufsgeheimnisträger Vertrags-, Zugriffs- und Infrastrukturvorgaben im eigenen Betriebsmodell abgrenzen.
ab 499,90 € netto / Monat
Leistung ansehenDrei fachlich angrenzende Wege statt einer langen Liste weiterer Produkte.
Alle Preise verstehen sich netto zuzüglich gesetzlicher Umsatzsteuer. Die Angebote richten sich an Unternehmen.
Gesamtsystem ansehenAnfrage
Nennen Sie kurz Ausgangslage und Ziel für PrivateGPT. Wir ordnen Infrastruktur, Integration und laufenden Betrieb ein.
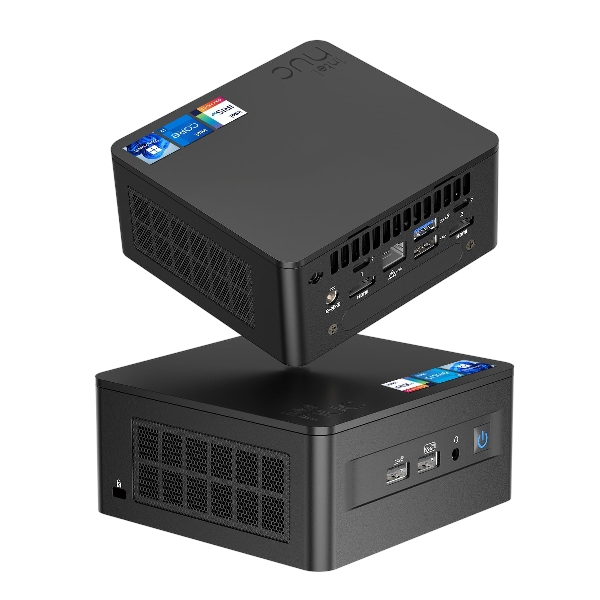
Der AI Cube deckt den kompakten Einstieg ab. Für größere Modelle, Rackmount oder hohe Parallelität planen wir individuelle GPU-Systeme.
Dedizierte NVIDIA GPU-Server in Deutschland inklusive abgestimmtem Modell, vLLM-Inferenzschicht, Open WebUI und laufendem Managed-Betrieb.
Kompakter lokaler KI-Server auf NVIDIA-GB10-Basis. Vollständig eingerichtet, gehärtet und mit einem vorab abgestimmten Modell vorbereitet.
Als Alternative zum Managed Hosting im Rechenzentrum stellt WZ-IT die Hardware bereit, richtet PrivateGPT ein und übernimmt Absicherung, Monitoring, Updates, Backup und technischen Support. Der Zugriff kann auf das interne Netz begrenzt oder über VPN und vorhandene Identitäten freigegeben werden.
ab 349 € netto / Monat · zzgl. einmalig Bereitstellung und Ersteinrichtung
Diese Lösungen werden oft zusammen mit PrivateGPT eingesetzt
Diese Lösungen bieten ähnliche Funktionalitäten und können gemeinsam evaluiert werden
Diese Lösungen sind direkte Alternativen mit ähnlichen Einsatzgebieten
Kein Risiko: Im schlechtesten Fall gehen Sie mit mehr Klarheit über Ihr Projekt heraus als vorher.
„Die Beratung von WZ-IT zu unserer Azure-Migration war schon im Erstgespräch fachlich sehr fundiert und völlig unverbindlich - wir haben eine Menge mitgenommen.“









“WZ-IT hat unsere Studio-Infrastruktur von dezentralen Einzelgeräten auf eine zentrale Plattform gehoben: Jeder Standort ist per VPN sicher angebunden, neue Geräte werden automatisiert onboardet und ein kompletter Standort wird per Vorlage provisioniert - ohne manuelle Schritte vor Ort. Was mich am meisten beeindruckt hat, ist die Breite und Tiefe des Wissens: Timo und Robin sind kein normaler IT-Dienstleister, der einen Server aufsetzt und wieder geht. Die beiden denken sich in hochkomplexe Infrastruktur- und Softwarethemen rein, arbeiten sich in jede Anforderung ein, die wir ihnen hinlegen, und bauen Vernetzung, Provisioning und Betrieb so auf, dass am Ende alles zusammenpasst. WZ-IT ist ein hervorragender Partner, wenn es um komplexe Software-, Netzwerk- und Architekturprojekte geht.”
Steve Kirchner
Geschäftsführer, nextGYM GmbH
“Professionell, ehrlich und fachlich absolut fundiert: WZ-IT hat unsere Proxmox- und Backup-Infrastruktur sicher und zukunftsfähig aufgestellt. Die Beratung durch Timo und Robin war sachlich und bedarfsorientiert, die Umsetzung reibungslos und die finale Dokumentation vorbildlich. Man merkt sofort, dass hier geschäftskritische Infrastruktur von Anfang an ganzheitlich gedacht und mit klarer Verantwortung umgesetzt wird.”
Pascal Block
Projektmanager, Stadtwerke Brühl GmbH
Stadtwerke Brühl - kommunaler Energie- und Infrastrukturdienstleister.
“Die Kommunikation mit WZ-IT war von Anfang an sehr offen, freundlich und professionell. Herr Wevelsiep und Herr Zins sind sehr geduldig, zeitnah und wertschätzend auf jede unserer Fragen eingegangen und haben eigene Vorschläge und gute Ideen eingebracht, wie wir unsere Serverinfrastruktur modernisieren und noch besser an unsere Bedürfnisse anpassen können. WZ-IT hat dabei stets unseren Wunsch nach Datenhoheit und Unterstützung von Datenschutzanforderungen berücksichtigt und konsequent mitgedacht. Selbst kurzfristige Anpassungen und Änderungswünsche von unserer Seite wurden schnell und geduldig umgesetzt und konsequent in das Gesamtkonzept integriert. Von der Planung bis hin zur abschließenden Übergabe wurden alle Schritte transparent und umfassend dokumentiert, was uns ermöglicht, falls ein Dienstleisterwechsel nötig werden sollte, diesen anhand der Dokumentation sehr schnell in unsere Infrastruktur einzuweisen. Wir sind äußerst zufrieden mit WZ-IT und hoffen, dass wir noch lange zusammenarbeiten werden.”
Christoph Mußmann
Projektreferent, DGHO e.V.
DGHO - Deutsche Gesellschaft für Hämatologie und Medizinische Onkologie e.V.
“Timo und Robin habe ich als engagierte und professionelle Gesprächspartner kennengelernt, die für einen Kunden so einiges möglich machen, das erst mal unmöglich scheint. Ich fühlte mich sehr gut beraten. Die angebotenen Leistungen haben mich sehr überzeugt.”
Andrea Pawlowski
Communications Manager, Golem.de
Golem.de - führendes deutsches IT-Fachmedium.

“Auf der Suche nach einem Partner für die Integration einer lokalen KI-Lösung sind wir auf Timo und Robin gestoßen - und hätten keine bessere Entscheidung treffen können. Unsere Anforderungen wurden schnell verstanden und technische Herausforderungen kompetent und praxisorientiert gelöst. Besonders überzeugt haben uns die unkomplizierte Zusammenarbeit, die hohe Fachkompetenz und die schnelle Umsetzung. Wir freuen uns, Timo und Robin als zuverlässige Geschäftspartner an unserer Seite zu haben, und blicken gespannt auf die nächsten gemeinsamen Projekte.”
Henrik Jeche
Head of IT Administration | Leiter IT-Administration
ml&s - Full-Service-Anbieter für die Elektronikindustrie.

“Mit Timo und Robin ist man nicht nur technisch auf der sicheren Seite - sondern auch menschlich bestens betreut! Ob es um schnelle Hilfe im Alltag oder komplexe IT-Lösungen geht: Die Jungs von WZ-IT denken mit, handeln schnell und sprechen eine Sprache, die man versteht. Die Zusammenarbeit ist unkompliziert, zuverlässig und immer auf Augenhöhe. So macht IT richtig Spaß - und vor allem: Sie funktioniert! Großes Dankeschön an das Team!”
Sonja Aßer
Data Manager, ARGE
ARGE Neue Medien - Stammdaten & digitale Standards für die SHK- und Gebäudetechnik.
“Ich habe vor kurzem mit Timo und dem WZ-IT Team zusammengearbeitet, und ehrlich gesagt war es eine der besten Tech-Entscheidungen, die ich für mein Unternehmen getroffen habe. Von Anfang an hat sich Timo die Zeit genommen, mir jeden Schritt ruhig und verständlich zu erklären. Egal wie viele Fragen ich hatte, er hat mich nie gehetzt. Die Ergebnisse sprechen für sich: Mit WZ-IT haben wir unsere monatlichen Ausgaben von 1.300 $ auf 250 $ reduziert. Das war ein riesiger Gewinn für uns. (übersetzt)”
Aleksandr Shuliko
CTO, EVA Real Estate
EVA Real Estate - führende Immobilienagentur in Dubai.

“WZ-IT verwaltet unser Proxmox-Cluster zuverlässig und professionell. Das Team übernimmt für uns das kontinuierliche Monitoring und regelmäßige Updates und reagiert sehr schnell auf Probleme oder Anfragen. Durch den proaktiven Support von WZ-IT bleiben unser Cluster und die darauf laufenden geschäftskritischen Anwendungen stabil, und die Hochverfügbarkeit ist durchgehend gewährleistet. Wir schätzen die professionelle Zusammenarbeit und die spürbare Entlastung im Tagesgeschäft. (übersetzt)”
Pascal Hakkers
Aphy AG
Aphy AG - KI-Plattform für das Backoffice in der Hotellerie.

“WZ-IT hat uns bei der Umsetzung unserer Server- und Virtualisierungsinfrastruktur sehr kompetent unterstützt. Im Rahmen des Projekts wurde eine Proxmox-basierte Virtualisierungsumgebung aufgebaut und eine virtuelle Maschine für unsere Anwendungssysteme eingerichtet. Darüber hinaus wurde ein strukturiertes Backup-Konzept implementiert. Ein besonderer Fokus lag auf dem Thema Sicherheit: Die Einrichtung eines VPN-Tunnels sowie die saubere Umsetzung von Verschlüsselungs- und Zugriffskonzepten wurden professionell umgesetzt. Hervorzuheben ist die strukturierte Beratung sowie die zuverlässige und zügige Umsetzung. Wir sind mit der erbrachten Leistung sehr zufrieden und empfehlen WZ-IT gerne weiter.”
John Hellmerichs
Geschäftsführer, AInergy GmbH
AInergy - Beratung für Energie- und Facility-Management.
“Wir haben sehr gute Erfahrungen mit Herrn Wevelsiep und WZ-IT gemacht. Die Beratung war professionell, klar verständlich und zu fairen Preisen. Das Team hat nicht nur unsere Anforderungen umgesetzt, sondern mit- und proaktiv weitergedacht. Statt nur einzelne Aufträge abzuarbeiten, wurden uns fundierte Erklärungen geliefert, die unser eigenes Verständnis gestärkt haben. WZ-IT uns mit ihrer strukturierten Herangehensweise viel Druck abgenommen - das war genau das, was wir brauchten und ist der Grund, warum wir immer wieder gerne zurück kommen.”
Matthias Zimmermann
Geschäftsführer, Annota GmbH
Annota - HealthTech-Startup mit KI-Dokumentationsassistent.
“Timo und Robin von WZ-IT haben für uns einen RocketChat-Server aufgesetzt - und ich könnte nicht zufriedener sein! Von der ersten Beratung bis zur finalen Implementierung lief alles absolut professionell, effizient und zu meiner vollsten Zufriedenheit. Besonders schätze ich die klare Kommunikation, die transparente Preisgestaltung und das umfassende Fachwissen, das die beiden mitbringen. Auch nach der Einrichtung übernehmen sie die Wartung, was mir enorm den Rücken freihält und mir ermöglicht, mich auf andere wichtige Bereiche meines Business zu konzentrieren - mit dem guten Gefühl, dass unsere IT in den besten Händen ist. Ich kann WZ-IT uneingeschränkt weiterempfehlen und freue mich auf die weitere Zusammenarbeit!”
Sebastian Maier
Geschäftsführer, Yonju GmbH
Yonju - Business-Coaching und KI-Produkte.

“Auf das WZ-IT Team zu setzen war entscheidend. Ihre Expertise und Lösungen haben uns das Tempo gegeben, unsere Services in Produktion zu deployen - inklusive Verbesserungsvorschlägen für unsere Konfiguration. Wir freuen uns auf die weitere Zusammenarbeit für Wartung und neue Lösungen. (übersetzt)”
Gabriel Sanz Señor
Geschäftsführer, Odiseo Solutions
Odiseo Solutions - Softwareentwicklung für die Raumfahrt.
Ob konkrete IT-Herausforderung oder einfach eine Idee - wir freuen uns auf den Austausch. In einem kurzen Gespräch prüfen wir gemeinsam, ob und wie Ihr Projekt zu WZ-IT passt.
Unternehmen weltweit vertrauen WZ-IT


